Recent articles
Cómo construí Framed by Santi: de cero a producción en tres días.
📸 Introducción: un portfolio de fotografía en producción al tercer día
Framed by Santi es la web de @framedbysanti, un fotógrafo aficionado que dispara con una Fujifilm X100VI por las calles de Nueva York. Tiene dos caras: una web pública para enseñar sus fotos y un panel privado para que él mismo publique sin depender de nadie.
Empezó como un regalo para un amigo, pero este post no va de eso: va de cómo la construí en muy poco tiempo, asistido por Claude Code, sin renunciar a la calidad.
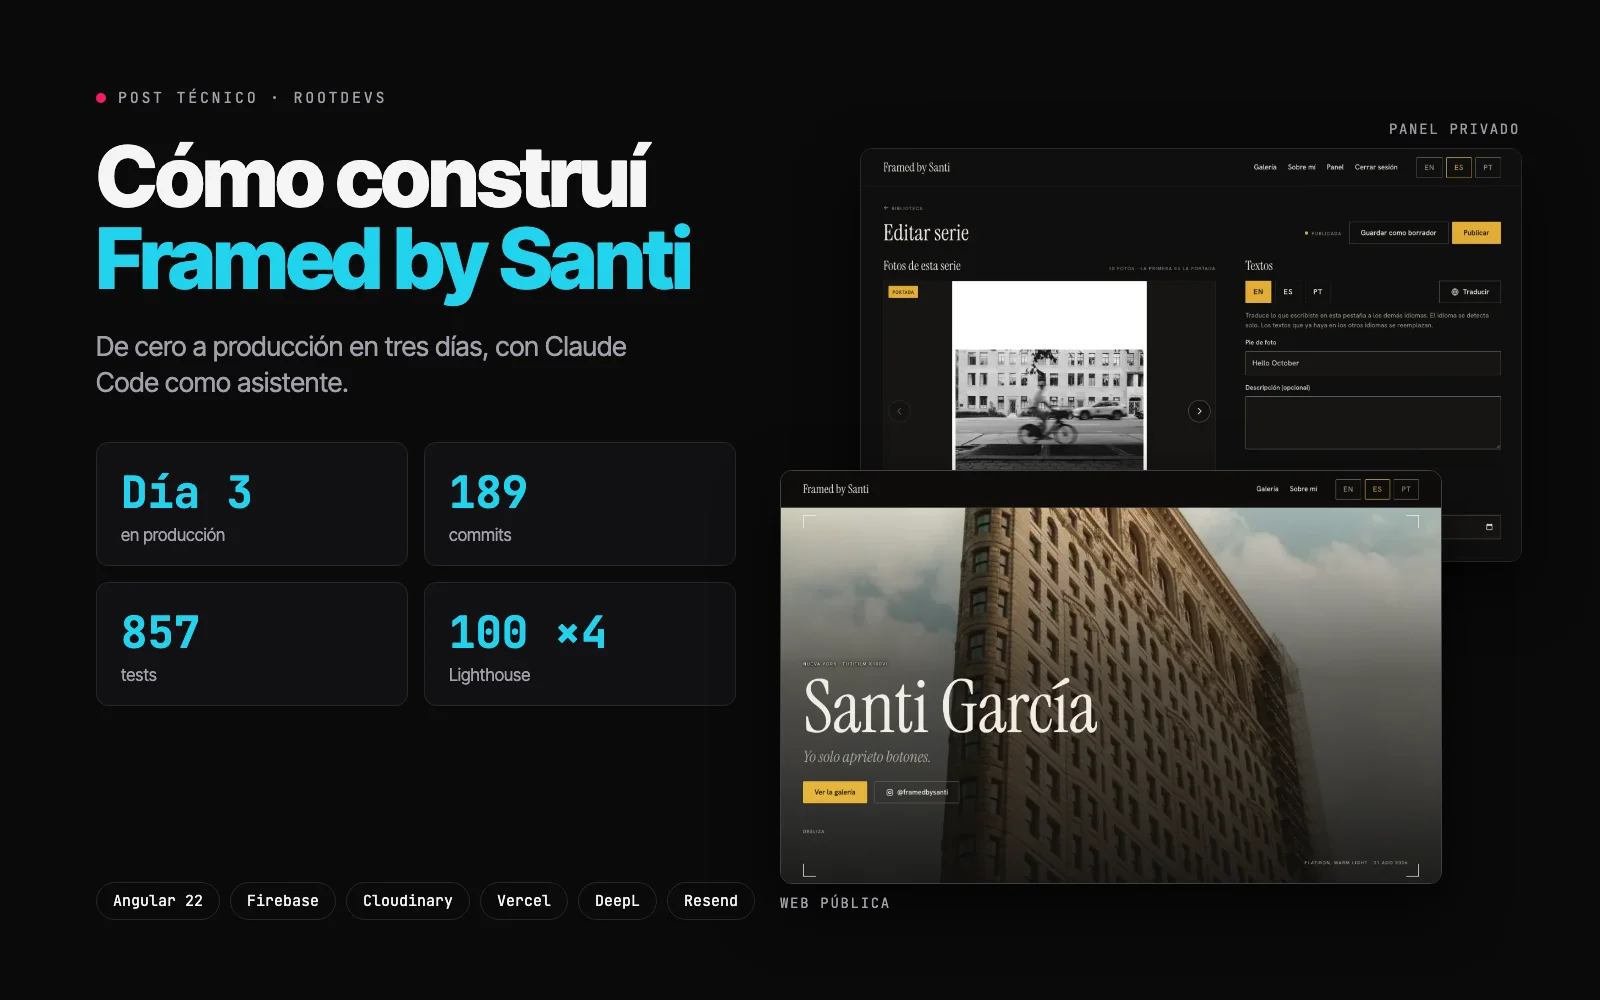
Las cifras, sacadas del repositorio:
📅 9 días con commits, del 13 al 26 de octubre de 2026.
🚀 En producción el día 3: web pública y panel privado.
🔀 189 commits y 35 pull requests; cada cambio lo probé yo, como visitante y como admin, antes de llegar a producción.
🧪 117 archivos de test con 857 casos.
🌍 Tres idiomas: inglés, español y portugués.
💯 100 en las cuatro categorías de Lighthouse (escritorio, red 4G).
🤖 Cómo lo trabajé: agentes de IA, pero con método
La construí en la terminal con agentes de IA (Claude Code) configurados con gentle-ai, la herramienta de código abierto de Alan Buscaglia (Gentleman Programming). No es "pedirle una web a la IA": es un flujo de trabajo con reglas.
ODD (Organic-Driven Development): los cambios pequeños se hacen directamente; el trabajo grande lleva un documento de tareas con los requisitos copiados literalmente, para que nada se pierda entre sesiones.
Engram: memoria persistente. Cada decisión, error resuelto o preferencia queda guardada y el agente la recupera en la siguiente sesión. Por ejemplo: "pregunta antes de hacer push, incluso a staging".
Tests primero: para cada regla nueva, primero un test que falla y después el código que lo hace pasar.
Ramas y revisión: cada cambio sale de una rama, sube a develop, lo pruebo en staging y solo llega a main (producción) cuando yo lo apruebo.
El reparto fue claro:
🤖 El agente: escribió el código y los tests, investigó los errores, propuso soluciones y abrió los PR.
🙋 Yo: decidí qué construir y cómo tenía que funcionar, revisé cada cambio, corregí al agente cuando se equivocaba y aprobé cada subida a producción.
💡 La IA escribe rápido; lo que hace que el resultado sea bueno es verificar. Cada PR pasó lint, tests y build, y ningún cambio llegó a producción sin mi aprobación.
🧱 Stack y arquitectura
Frontend
Angular 22 sin Zone.js (zoneless), con Signals para todo el estado y componentes standalone.
TypeScript 6 en modo estricto: sin any y con tipos de retorno explícitos.
CSS nativo con nesting, BEM y mobile-first. Sin preprocesador.
Vite 8 con @analogjs/vite-plugin-angular como única herramienta de build.
Transloco para los tres idiomas.
Servicios
Vercel: hosting y cuatro funciones serverless.
Firebase Auth y Firestore: login del panel y datos (series, temas, ajustes).
Cloudinary: almacenamiento y entrega de fotos, con subidas firmadas.
DeepL: traducción automática de los textos.
Resend: el email del formulario de contacto.
Las cuatro funciones de api/
Función
Qué hace
sign-upload
Comprueba que quien llama es admin y firma la subida a Cloudinary.
translate
Proxy a DeepL, solo para admins, con 10 segundos de límite.
cleanup-photos
Borra de Cloudinary las fotos que ya no usa nada.
contact
Valida el formulario y envía el email con Resend.
Las tres del panel comprueban que el usuario es admin de la misma forma: leen su documento en Firestore con el token del propio usuario, así que son las reglas de seguridad de Firestore las que deciden, no un secreto en el servidor.
🖼️ La web pública
Las publicaciones son series, como un carrusel de Instagram: varias fotos con un título y una historia.
Home con la última serie en un carrusel que se puede arrastrar.
Galería con una sección por serie y filtro por temas.
Visor a pantalla completa: zoom y desplazamiento (pellizcar, arrastrar, doble toque, rueda), gestos para pasar de foto, miniaturas, precarga de la siguiente foto y un fundido entre fotos.
View Transitions entre páginas, con un efecto de iris como el diafragma de una cámara.
Sobre mí con la historia de Santi en sus palabras y un formulario de contacto. Su email nunca llega a la página.
Idiomas de verdad: fechas, números y plurales siguen el idioma activo (en-US, es-ES, pt-PT).
Con prefers-reduced-motion no se anima nada.
La home. Haz clic para verla en vivo.
La galería con el filtro por temas.
El visor: zoom, flechas y miniaturas.
🔐 El panel privado
El panel vive en /admin y no tiene ningún enlace público: se llega solo escribiendo la ruta.
Biblioteca de series: interruptor de publicada o borrador, editar y borrar.
Editor de series: arrastrar fotos, previsualizarlas, reordenarlas y escribir los textos en una pestaña por idioma.
Fotos preparadas en el navegador: antes de subir, cada foto se redimensiona y se recomprime hasta un máximo de 6000 px y 10 MB, bajando la calidad del JPEG por pasos hasta que cabe. Así se respetan los límites del plan gratuito de Cloudinary sin que Santi tenga que pensar en ello.
Traducción automática: Santi escribe en un idioma y, al publicar, DeepL rellena los que faltan. Cada idioma se puede corregir a mano.
Temas: se crean y se borran desde el panel.
Limpieza automática: al abrir la biblioteca, se borran en segundo plano las fotos de Cloudinary que ya no usa ninguna serie.
Ajustes: foto de perfil y cambio de contraseña.
También en el móvil: el panel se adapta a la pantalla del teléfono, y en el login se puede mostrar u ocultar la contraseña.
Y un easter egg solo para el admin: un rincón para seguir con fuerzas. 💪
La biblioteca: cada serie se publica o se pasa a borrador con un interruptor.
El editor: fotos a la izquierda, textos por idioma y el botón para traducir a la derecha.
⚡ Rendimiento: medir, recortar y volver a medir
El rendimiento no lo dejé para el final: medí con Lighthouse, ataqué lo que más pesaba y volví a medir. Así queda hoy en escritorio con red 4G:
Primera ronda: de 44 a 73 en móvil
La primera medición, el 15 de octubre en móvil con 4G lenta (el caso más exigente), dio un rendimiento de 44-48, con un CLS de 0,333 y un LCP de 7,5 s. Con tres cambios lo arreglé casi todo:
Precargar la foto principal de la home desde index.html, con fetchpriority="high". El script de precarga va antes de cualquier hoja de estilos, porque una hoja pendiente bloquea los scripts que vienen detrás.
La home va en el paquete principal, sin carga diferida, para no añadir un viaje de red antes de pintar la primera página.
El footer se pinta después de la primera navegación. Era el responsable de todo el CLS. El carrusel de la última serie también reserva su espacio mientras carga.
Resultado en móvil: rendimiento 73, CLS 0,001 y LCP 5,6 s.
Segunda ronda: quitar lo que no hacía falta
Fuentes propias. Las sirvo desde el propio dominio, sin la ida y vuelta a Google Fonts.
Firebase fuera de las páginas públicas. Al revisar el build vi que el paquete de Firebase pesaba 563 kB (168 kB comprimidos) y se precargaba en todas las páginas, y que cada visita abría además un iframe de autenticación de Google de unos 93 KiB. Todo eso para leer unas series que son públicas. Ahora las páginas públicas leen Firestore con fetch contra su API REST, con las mismas reglas de seguridad.
El login solo se carga si hace falta: una marca local indica que en ese navegador ya entró un admin. Los visitantes nunca descargan Firebase Auth. Y la marca no da ningún permiso: la comprobación real sigue siendo Firebase.
Resultado en escritorio con red 4G: 100 en Performance, Accessibility, Best Practices y SEO.
Lo que viene de serie
Imágenes responsive: cada foto se sirve desde Cloudinary con srcset en cinco anchos (480, 800, 1200, 1600 y 2400 px) y formato y calidad automáticos.
Cada página se carga cuando se visita (lazy loading), salvo la home.
💡 La lección: medir antes de optimizar. El mayor problema de CLS era un footer, y el mayor peso, una librería que los visitantes ni siquiera usaban.
🛡️ Seguridad
Reglas de Firestore que deniegan todo por defecto. El público solo puede leer las series publicadas, y los ajustes solo aceptan los campos permitidos.
Subidas firmadas: el navegador nunca tiene permiso para subir a Cloudinary por su cuenta; cada subida la firma una función que antes comprueba que eres admin.
Formulario de contacto con límites de longitud, HTML escapado y un campo trampa: los bots lo rellenan, reciben un "OK" y no se envía nada.
Staging no se indexa: los builds de staging llevan noindex y un robots.txt que lo prohíbe todo.
🧪 Calidad: el orden no se negocia, lo impone el linter
Cuando la IA escribe la mayor parte del código, las convenciones no pueden depender de que alguien se acuerde de ellas. Por eso las convertí en reglas: si el código no sigue el orden, el lint falla, da igual quién lo haya escrito. Las reglas están desde el primer día del proyecto.
Cinco reglas de ESLint propias, escritas para este proyecto:
Regla
Qué obliga
¿Se arregla sola?
component-decorator-order
Las propiedades de @Component siempre en el mismo orden: standalone, changeDetection, imports, selector, styleUrl, templateUrl...
✅
inject-before-signals
Las llamadas a inject() van antes que cualquier otra propiedad de la clase.
✅
alphabetical-component-imports
El array imports del componente, en orden alfabético.
✅
alphabetical-inputs-signals
Los input() y los signal(), en orden alfabético dentro de su grupo.
❌
alphabetical-interface-members
Los miembros de interfaces y tipos, en orden alfabético.
❌
Las dos últimas solo avisan, no reordenan solas: en las interfaces, por ejemplo, mover miembros puede romper código que usa spread u Object.assign, así que prefiero que lo decida una persona.
Y el resto del orden, también automático:
Imports agrupados y ordenados: primero Angular y librerías externas, luego los alias internos (@core, @features...) y al final los relativos.
Claves de objetos en orden alfabético en datos, constantes, modelos e interfaces.
JSON de traducción con las claves ordenadas, sin comentarios.
Prettier con plugins que ordenan las propiedades CSS, los atributos HTML y las claves de los JSON.
TypeScript estricto: any es un error, los tipos de retorno son obligatorios y se usa siempre ===.
El patrón diccionario
Hay una práctica que pido siempre y que no impone ningún linter: el patrón diccionario, que en inglés se conoce como object lookup (y como dispatch table cuando los valores son funciones). Cuando una función traduce un valor a otro, nada de switch ni de if/else encadenados: un objeto tipado con Record, acceso por clave y un valor por defecto con ??.
const TRANSLATE_ERRORS: Record<TranslationError['reason'], string> = {
failed: 'admin.editor.translate.errors.failed',
limit: 'admin.editor.translate.errors.limit',
'not-allowed': 'admin.editor.translate.errors.notAllowed',
};
Tres ventajas:
Se lee de un vistazo: todos los casos en una tabla, en lugar de repartidos entre ramas.
TypeScript vigila que no falte ninguno: con Record<TranslationError['reason'], string>, si mañana aparece un motivo de error nuevo, el código no compila hasta que tenga su texto.
Añadir un caso es añadir una línea, sin tocar la lógica.
Si en vez de un valor necesitas ejecutar algo, los valores pasan a ser funciones: es la dispatch table. Aquí hay una trampa que yo mismo tenía en mis apuntes:
const LOKI_DEFAULT_DISFRAZ = 'Loki';
const LOKI_DISFRACES = {
Hulk: () => 'Thanos',
Thor: () => 'Odin',
};
// ❌ Si el enemigo no está en la tabla: TypeError, ... is not a function
const disfraz = LOKI_DISFRACES[enemy]() ? LOKI_DISFRACES[enemy]() : LOKI_DEFAULT_DISFRAZ;
// ✅ Con ?.() no se ejecuta nada si no existe, y ?? pone el valor por defecto
const disfraz = LOKI_DISFRACES[enemy]?.() ?? LOKI_DEFAULT_DISFRAZ;
La primera versión, además de romperse con una clave desconocida, ejecuta la función dos veces. Y ?? es mejor que el ternario: solo usa el valor por defecto cuando la clave no existe, no cuando el resultado es un '' o un 0 válidos.
No es dogma: en las plantillas uso @switch cuando cada caso pinta algo distinto, y queda algún switch donde cada rama hace más que devolver un valor.
Y los tests:
857 casos en 117 archivos, con Vitest y JSDOM, también para las funciones de api/.
Commits convencionales validados por un script.
🐛 Cinco problemas reales (y cómo los resolví)
1. Pestañas que se rompían después de cada deploy
Una pestaña abierta antes de un deploy pedía archivos del build anterior, que ya no existían. Las páginas que se cargan al visitarlas (galería, Sobre mí, el panel) no se abrían y no decían nada.
La solución fue un manejador de errores de navegación que, si falla la descarga de una parte de la app, recarga esa página desde cero para obtener el build nuevo. Solo lo hace para errores de descarga y una sola vez seguida por página, así que una caída real no puede provocar un bucle de recargas.
2. Quitar Firebase de las páginas públicas
El ahorro está contado en la sección de rendimiento; lo delicado fue la seguridad. Separé el login en un almacén que se carga bajo demanda, y la marca local que decide cuándo cargarlo no concede nada: si alguien la falsifica, solo consigue descargar Firebase Auth, porque la comprobación real sigue siendo el login y el documento de admin en Firestore.
3. Las funciones de Vercel y los módulos ES
Las funciones de api/ fallaban en Vercel: como módulos ES nativos, los imports relativos necesitan la extensión .js. Además del arreglo, añadí un test que comprueba todos los imports de api/ para que no vuelva a pasar.
4. Una limpieza de fotos que no puede equivocarse
Borrar fotos "huérfanas" es fácil; borrar solo las huérfanas, no tanto. La limpieza fue aprendiendo con cada caso:
Si no puede leer las series, no borra nada. Una lectura fallida no significa que no haya fotos en uso.
Solo da por borradas las fotos que Cloudinary confirma.
Respeta la foto de perfil y las del rincón del admin, que viven en la misma carpeta.
No toca fotos de menos de 7 días y borra como mucho 100 por ejecución.
5. "Guardando…" para siempre
Al guardar la foto de perfil con una conexión lenta, si el guardado tardaba demasiado la app preguntaba al servidor si había llegado... sin límite de tiempo para esa pregunta. Ahora esa comprobación tiene su propio límite de 5 segundos, y la lectura de la sesión guardada en IndexedDB se rinde a los 2 segundos, porque algunos navegadores nunca responden.
📅 Día a día
Día
Commits
Qué pasó
13 oct
1
Proyecto creado: Angular, i18n y herramientas.
14 oct
43
Prototipo completo de la web pública y fotos desde Cloudinary.
15 oct
75
Reglas de Firestore, login, subidas firmadas, editor, traducción, temas, limpieza, página 404. Primera subida a producción.
16 oct
3
Fuentes propias.
19 oct
22
Páginas públicas sin el SDK, login bajo demanda, ajustes del panel.
20 oct
7
Historia de Sobre mí y ajustes en móvil.
21 oct
23
Icono de Instagram, el rincón del admin y el formulario de contacto.
22 oct
3
Pulido del email de contacto.
26 oct
12
Panel adaptado al móvil, mostrar la contraseña en el login y mejoras en el rincón del admin.
🎯 Lecciones
La velocidad sale del método, no solo de la IA. Requisitos por escrito, tests primero, ramas y revisión: sin eso, 75 commits en un día serían 75 problemas.
La memoria persistente cambia el juego. Que el agente recuerde decisiones y errores de sesiones anteriores evita repetirlos.
Verificar gana a generar. Nada llegó a producción sin pasar tests, lint y build.
Los servicios gratuitos dan para mucho si diseñas pensando en sus límites (Cloudinary, Firebase, DeepL Free, Resend y Vercel).
La seguridad no se delega en el frontend. Las reglas de Firestore y las funciones con comprobación de admin son las que protegen; la interfaz solo acompaña.
⭐ gentle-ai en GitHub: github.com/Gentleman-Programming/gentle-ai. Si te resulta útil, dale una estrella.
Francisco Javier Antúnez Durán3 weeks ago
YouTube no reproduce en mi Mac: cinco pistas falsas y un culpable inesperado.
🎬 Introducción: la página carga, el vídeo no
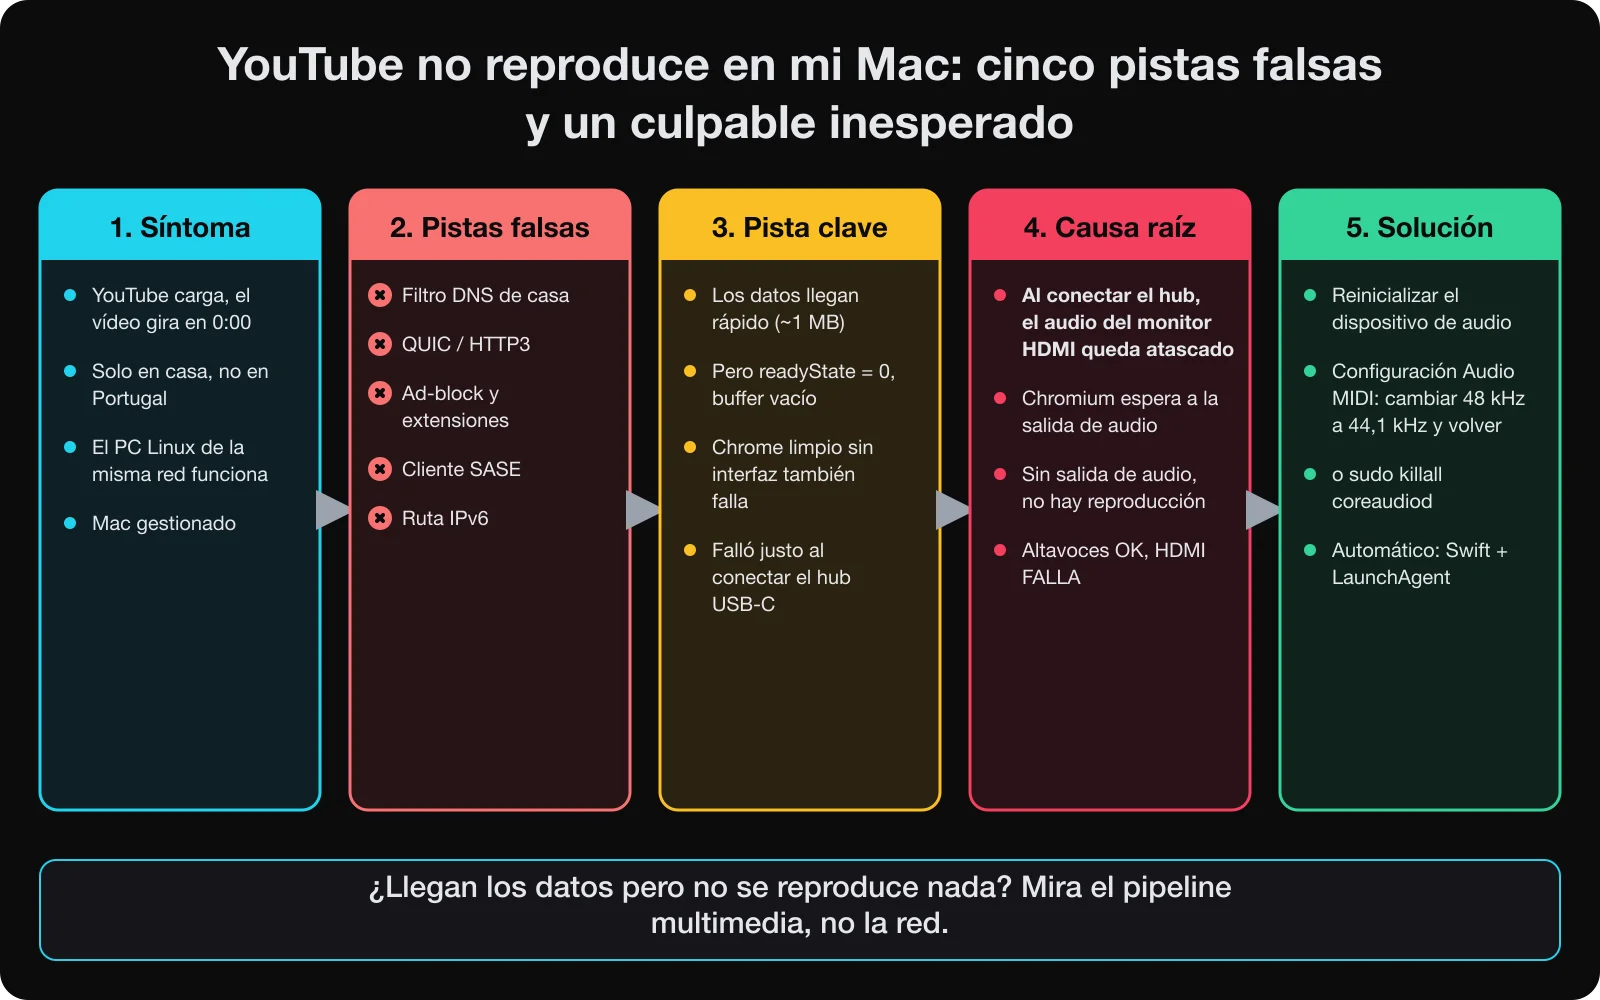
Mi MacBook de empresa llevaba cuatro años funcionando perfecto con este montaje: un hub USB-C (Ethernet, webcam y salida VGA hacia una tele) y un monitor externo por HDMI cuyo audio uso, con el conector de auriculares del monitor alimentando los altavoces de la tele. Hasta que un día YouTube dejó de reproducir: la página cargaba perfecta, pero el vídeo se quedaba girando para siempre en el 0:00.
Así se ve mi mesa de trabajo:
Lo más desconcertante era el patrón. Pasaba en casa, pero no en mi segunda vivienda, con otro ISP. Y un PC con Linux en la misma red doméstica, con el mismo navegador, funcionaba sin problemas. Todo apuntaba a la red o al proveedor de internet, combinados con un Mac gestionado por la empresa (MDM, un cliente SASE de secure web gateway, un perfil de DNS cifrado gestionado y un agente de seguridad de endpoint). Demasiados sospechosos.
💡 Spoiler: la red era inocente. Pero tardé horas en aceptarlo, y el camino es lo que vale la pena contar.
🤖 Cómo lo trabajé: iterando con agentes
Esta investigación no la hice solo. Trabajé en la terminal con agentes de IA (Claude Code) configurados con gentle-ai, una herramienta de código abierto (web oficial) que configura los agentes que ya usas con memoria persistente, Organic-Driven Development, skills y orquestación de sub-agentes, sin atarte a ninguno.
Lo que aportó gentle-ai en este caso:
Engram: memoria persistente entre sesiones, para no empezar de cero cada vez.
ODD (Organic-Driven Development): un flujo ligero, con documento de tareas para el trabajo sustancial, rama antes de escribir y ningún commit sin mi permiso explícito.
Orquestación de sub-agentes: el orquestador delegó en escritores que redactaron este post en tres idiomas y generaron los diagramas; yo revisé y corregí.
gentle-ai lo creó Alan Buscaglia (Gentleman Programming), y su regla para trabajar con IA resume bien este post: "verifying beats generating", es decir, verificar gana a generar.
⭐ gentle-ai en GitHub: github.com/Gentleman-Programming/gentle-ai. Si te resulta útil, dale una estrella: ayuda a que más gente lo encuentre.
El método fue siempre el mismo, y nos equivocamos los dos: el agente también defendió teorías erróneas (la del cliente SASE y la caché del ISP fue suya) y la evidencia lo corrigió a él igual que a mí.
hipótesis → prueba → evidencia → descartar
🤖 El agente: leyó logs de sistema y de red, inspeccionó configuraciones, capturó y decodificó el tráfico del reproductor, lanzó Chrome sin interfaz por DevTools, montó el monitor de reproducción, ejecutó las pruebas de aislamiento y escribió el vigilante en Swift con su LaunchAgent.
🙋 Yo: aporté contexto y capturas, hice las comprobaciones en el navegador que el agente no podía y, sobre todo, noté que fallaba justo al conectar el hub USB-C y confirmé que el montaje llevaba cuatro años funcionando igual.
🕵️ Pista falsa #1: el filtro DNS de casa
Lo primero fue lo más obvio: el Pi-hole de casa. Lo descartamos antes de empezar en serio, con evidencia: el DNS resolvía todo correctamente y solo bloqueaba dominios de publicidad. Nada que ver con los servidores de vídeo.
🚦 Pista falsa #2: QUIC / HTTP3
El clásico de "la página carga pero el vídeo no": un firewall o un proveedor que rompe QUIC. Desactivamos QUIC en el navegador (brave://flags/#enable-quic) y el vídeo siguió fallando. Descartado.
🧩 Pista falsa #3: bloqueadores y extensiones
En la consola aparecían errores net::ERR_BLOCKED_BY_CLIENT para la telemetría de YouTube (qoe, log_event, generate_204). Muy sospechoso... hasta que probamos en una ventana privada con los shields desactivados: la telemetría pasaba y el vídeo seguía atascado. Aquellos errores eran ruido.
🛡️ Pista falsa #4: el cliente SASE
Esta fue la más convincente. La extensión de red del cliente SASE seguía activa aunque la "desactivara" desde su interfaz (protección anti-manipulación), y sus logs, que leyó el agente, mostraban que gestionaba flujos del navegador hacia googlevideo.com. Además, mi proveedor servía el vídeo desde un nodo de caché de Google dentro de su propia red. La hipótesis, que fue del propio agente, encajaba de maravilla: el tráfico que sale por la nube del SASE es rechazado por la caché del ISP.
La desmontaron tres hechos:
El certificado que recibía el navegador era el genuino de Google: no había interceptación TLS.
El nodo de caché respondía sin problema (un 204 correcto).
Y lo decisivo: Chrome ni siquiera pasa por ese cliente (cero flujos en su log) y fallaba exactamente igual.
👻 Pista falsa #5: la "ruta fantasma" de IPv6
Otro asistente de IA sugirió un problema de IPv6. Lo comprobó el agente, que después retractó la idea: el Mac no tenía IPv6 global, las rutas por defecto utun estaban ligadas a interfaz (son túneles del sistema), el intento IPv6 del navegador fallaba al instante y caía a IPv4, y mi red doméstica ni siquiera tiene IPv6. Descartado. Tampoco eran la cuenta ni las cookies: un perfil de Chrome totalmente limpio, sin cookies, sin cuenta y sin extensiones, también se quedaba colgado.
🔬 La pista que estaba a la vista
Durante todo el proceso hubo una observación que en retrospectiva apuntaba lejos de la red. La respuesta de YouTube era válida: un stream SABR/UMP de aproximadamente 1 MB con audio y vídeo reales y el estado de protección de stream en OK. Los bytes llegaban rápido. Pero el reproductor nunca los consumía: video.readyState se quedaba en 0, buffered vacío y el reproductor en estado 3 (buffering).
"Los datos llegan, pero el reproductor no arranca." Eso no es un problema de red.
🔁 El giro: convertirlo en algo reproducible
Tras reiniciar el Mac funcionó... y más tarde volvió a romperse. Así que dejé de adivinar y le pedí al agente que montara un monitor: cada 2 minutos lanzaba un Chrome limpio y sin interfaz a través del protocolo DevTools, cargaba un vídeo, comprobaba readyState y currentTime, y guardaba una instantánea del sistema en cada cambio de estado.
Entonces caí en la cuenta de algo, y esta parte fue mía, no del agente: se rompía justo cuando conectaba el hub USB-C, en un montaje que yo sabía que llevaba cuatro años funcionando igual. El agente hizo una prueba de aislamiento con el hub conectado:
Salida de audio
Chrome con --disable-audio-output
Chrome con audio
Altavoces del MacBook
OK
OK
Monitor HDMI (VS278)
OK
FALLA (atascado en 0:00)
Ahí estaba. Sin audio, el vídeo reproduce; con audio hacia el monitor HDMI, no.
🎯 La causa raíz: un dispositivo de audio atascado
Al conectar el hub, macOS reconfigura pantallas y dispositivos de audio, y el audio del monitor HDMI queda atascado, aunque nunca desaparece de la lista de dispositivos. Chromium no empieza la reproducción hasta que puede abrir la salida de audio, así que el vídeo espera para siempre aunque los datos ya hayan llegado.
Este es mi montaje, con el punto exacto donde falló:
Esto también explica el resto del misterio:
📍 "Solo pasa en casa": allí vive el montaje del hub y el monitor. La red era una pista falsa; la correlación de lugar era en realidad una correlación de hardware.
⏱️ "Se rompe a ratos": el hub es algo tembloroso y se toca. Cada reconexión vuelve a disparar el problema.
🔧 La solución manual
Basta con reinicializar el dispositivo de audio. Tres formas:
Abrir Configuración Audio MIDI, seleccionar el dispositivo HDMI y cambiar el formato de 48 000 Hz a 44 100 Hz y volver.
Cambiar la salida de sonido a otro dispositivo y devolverla.
Reiniciar el servicio de audio: sudo killall coreaudiod.
Una contraprueba confirmó que lo que arregla es el reinicio, no la frecuencia: 48 kHz vuelve a funcionar después de un reset. Fijar una frecuencia concreta no ayuda, porque macOS ya la recuerda por dispositivo.
🤖 La solución automática
Como el problema volvía con cada reconexión, le pedí al agente que lo automatizara y escribió un pequeño programa en Swift que usa CoreAudio y se ejecuta como LaunchAgent de usuario; lo revisé y lo instalé yo. Escucha los cambios en kAudioHardwarePropertyDevices, espera 4 segundos a que todo se asiente (debounce) y alterna la frecuencia nominal del dispositivo objetivo a otra disponible y de vuelta. La primera versión no se disparaba, porque el monitor nunca desaparece de la lista de dispositivos; el agente la corrigió para reaccionar a cualquier cambio en esa lista.
🧾 El programa (~/bin/hdmi-audio-reset.swift)
// Watches CoreAudio devices and re-initializes a given output device whenever the device
// list changes (e.g. after plugging a USB-C hub), by toggling its nominal sample rate.
// Works around the device getting stuck, which blocks Chromium media playback.
// usage: hdmi-audio-reset <deviceName> [--now]
import CoreAudio
import Foundation
let targetName = CommandLine.arguments.count > 1 ? CommandLine.arguments[1] : "VS278"
let settleSeconds: TimeInterval = 4
func log(_ message: String) {
let line = "\(ISO8601DateFormatter().string(from: Date())) \(message)\n"
FileHandle.standardError.write(line.data(using: .utf8)!)
}
func address(_ selector: AudioObjectPropertySelector) -> AudioObjectPropertyAddress {
AudioObjectPropertyAddress(mSelector: selector, mScope: kAudioObjectPropertyScopeGlobal, mElement: kAudioObjectPropertyElementMain)
}
func deviceIDs() -> [AudioDeviceID] {
var addr = address(kAudioHardwarePropertyDevices)
var size: UInt32 = 0
guard AudioObjectGetPropertyDataSize(AudioObjectID(kAudioObjectSystemObject), &addr, 0, nil, &size) == noErr else { return [] }
var ids = [AudioDeviceID](repeating: 0, count: Int(size) / MemoryLayout<AudioDeviceID>.size)
guard AudioObjectGetPropertyData(AudioObjectID(kAudioObjectSystemObject), &addr, 0, nil, &size, &ids) == noErr else { return [] }
return ids
}
func name(of id: AudioDeviceID) -> String? {
var addr = address(kAudioObjectPropertyName)
var value: Unmanaged<CFString>?
var size = UInt32(MemoryLayout<Unmanaged<CFString>?>.size)
guard AudioObjectGetPropertyData(id, &addr, 0, nil, &size, &value) == noErr else { return nil }
return value?.takeRetainedValue() as String?
}
func findTarget() -> AudioDeviceID? { deviceIDs().first { name(of: $0) == targetName } }
func sampleRate(of id: AudioDeviceID) -> Float64? {
var addr = address(kAudioDevicePropertyNominalSampleRate)
var rate: Float64 = 0
var size = UInt32(MemoryLayout<Float64>.size)
return AudioObjectGetPropertyData(id, &addr, 0, nil, &size, &rate) == noErr ? rate : nil
}
func availableRates(of id: AudioDeviceID) -> [Float64] {
var addr = address(kAudioDevicePropertyAvailableNominalSampleRates)
var size: UInt32 = 0
guard AudioObjectGetPropertyDataSize(id, &addr, 0, nil, &size) == noErr else { return [] }
var ranges = [AudioValueRange](repeating: AudioValueRange(), count: Int(size) / MemoryLayout<AudioValueRange>.size)
guard AudioObjectGetPropertyData(id, &addr, 0, nil, &size, &ranges) == noErr else { return [] }
return ranges.map { $0.mMinimum }
}
@discardableResult
func setSampleRate(_ id: AudioDeviceID, _ rate: Float64) -> OSStatus {
var addr = address(kAudioDevicePropertyNominalSampleRate)
var value = rate
return AudioObjectSetPropertyData(id, &addr, 0, nil, UInt32(MemoryLayout<Float64>.size), &value)
}
func resetTarget() {
guard let id = findTarget(), let current = sampleRate(of: id) else { log("\(targetName) not found; skipping"); return }
guard let other = availableRates(of: id).first(where: { $0 != current }) else { log("no alternate rate for \(targetName)"); return }
let first = setSampleRate(id, other)
Thread.sleep(forTimeInterval: 1)
let second = setSampleRate(id, current)
log("reset \(targetName): \(Int(current)) -> \(Int(other)) -> \(Int(current)) (status \(first)/\(second))")
}
let wasPresent = findTarget() != nil
if CommandLine.arguments.contains("--now") { resetTarget(); exit(0) }
log("watching for \(targetName) (present=\(wasPresent))")
if wasPresent { DispatchQueue.main.asyncAfter(deadline: .now() + settleSeconds) { resetTarget() } }
// Any device-list change (hub plugged/unplugged, displays reconfigured) can leave the
// target stuck even though it never disappears, so reset it after changes settle.
var pendingReset: DispatchWorkItem?
var devicesAddr = address(kAudioHardwarePropertyDevices)
AudioObjectAddPropertyListenerBlock(AudioObjectID(kAudioObjectSystemObject), &devicesAddr, DispatchQueue.main) { _, _ in
log("audio devices changed; resetting \(targetName) in \(Int(settleSeconds))s")
pendingReset?.cancel()
let work = DispatchWorkItem { resetTarget() }
pendingReset = work
DispatchQueue.main.asyncAfter(deadline: .now() + settleSeconds, execute: work)
}
dispatchMain()
📄 El LaunchAgent (~/Library/LaunchAgents/local.hdmi-audio-reset.plist)
Sustituye YOUR_USER por tu usuario y el nombre VS278 por el de tu dispositivo de audio.
<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE plist PUBLIC "-//Apple//DTD PLIST 1.0//EN" "http://www.apple.com/DTDs/PropertyList-1.0.dtd">
<plist version="1.0">
<dict>
<key>Label</key><string>local.hdmi-audio-reset</string>
<key>ProgramArguments</key>
<array><string>/Users/YOUR_USER/bin/hdmi-audio-reset</string><string>VS278</string></array>
<key>RunAtLoad</key><true/>
<key>KeepAlive</key><true/>
<key>StandardErrorPath</key><string>/Users/YOUR_USER/Library/Logs/hdmi-audio-reset.log</string>
</dict>
</plist>
▶️ Compilar e instalar
swiftc -O -o ~/bin/hdmi-audio-reset ~/bin/hdmi-audio-reset.swift
launchctl bootstrap gui/$(id -u) ~/Library/LaunchAgents/local.hdmi-audio-reset.plist
Para desinstalarlo:
launchctl bootout gui/$(id -u)/local.hdmi-audio-reset
Lo verifiqué de punta a punta: desconecté y volví a conectar el hub, el log mostró audio devices changed; resetting …, después el reinicio, y YouTube reprodujo sin tocar nada.
🧠 Lecciones
Descarta capas con evidencia, no con intuición. Cada pista falsa se cerró con una prueba concreta, no con una corazonada.
Desconfía de la primera historia plausible. El agente y yo perseguimos la red durante horas porque la historia encajaba demasiado bien (la teoría del SASE y la caché del ISP fue del propio agente).
"Los datos llegan pero nada suena" significa mirar el pipeline multimedia (audio, decodificador), no la red.
Haz el fallo reproducible y automático. Un monitor cada 2 minutos me dio lo que la intuición no pudo: el desencadenante.
Cambia una variable a la vez. La prueba de aislamiento con la tabla de arriba resolvió en minutos lo que horas de hipótesis no.
La correlación de lugar era una correlación de montaje de hardware.
La investigación la hice iterando con agentes de IA en la terminal (Claude Code, configurado con gentle-ai): ejecutaron y ordenaron las pruebas, y cayeron en teorías equivocadas igual que yo. Este post también lo redactaron sub-agentes orquestados por gentle-ai (el texto en tres idiomas y las ilustraciones), y lo revisé y corregí yo. Lo que nos hizo avanzar a los dos fue descartar con evidencia.
Si tienes un Mac, un hub USB-C y audio por HDMI, y YouTube se queda en el 0:00, prueba primero a reiniciar el dispositivo de audio. Te puede ahorrar una tarde entera. 🎧
Francisco Javier Antúnez Durán1 month ago
Código Impecable en Equipos Multi-Consultora.
🌪️ Introducción: El Caos Invisible de los Espacios y las Comas
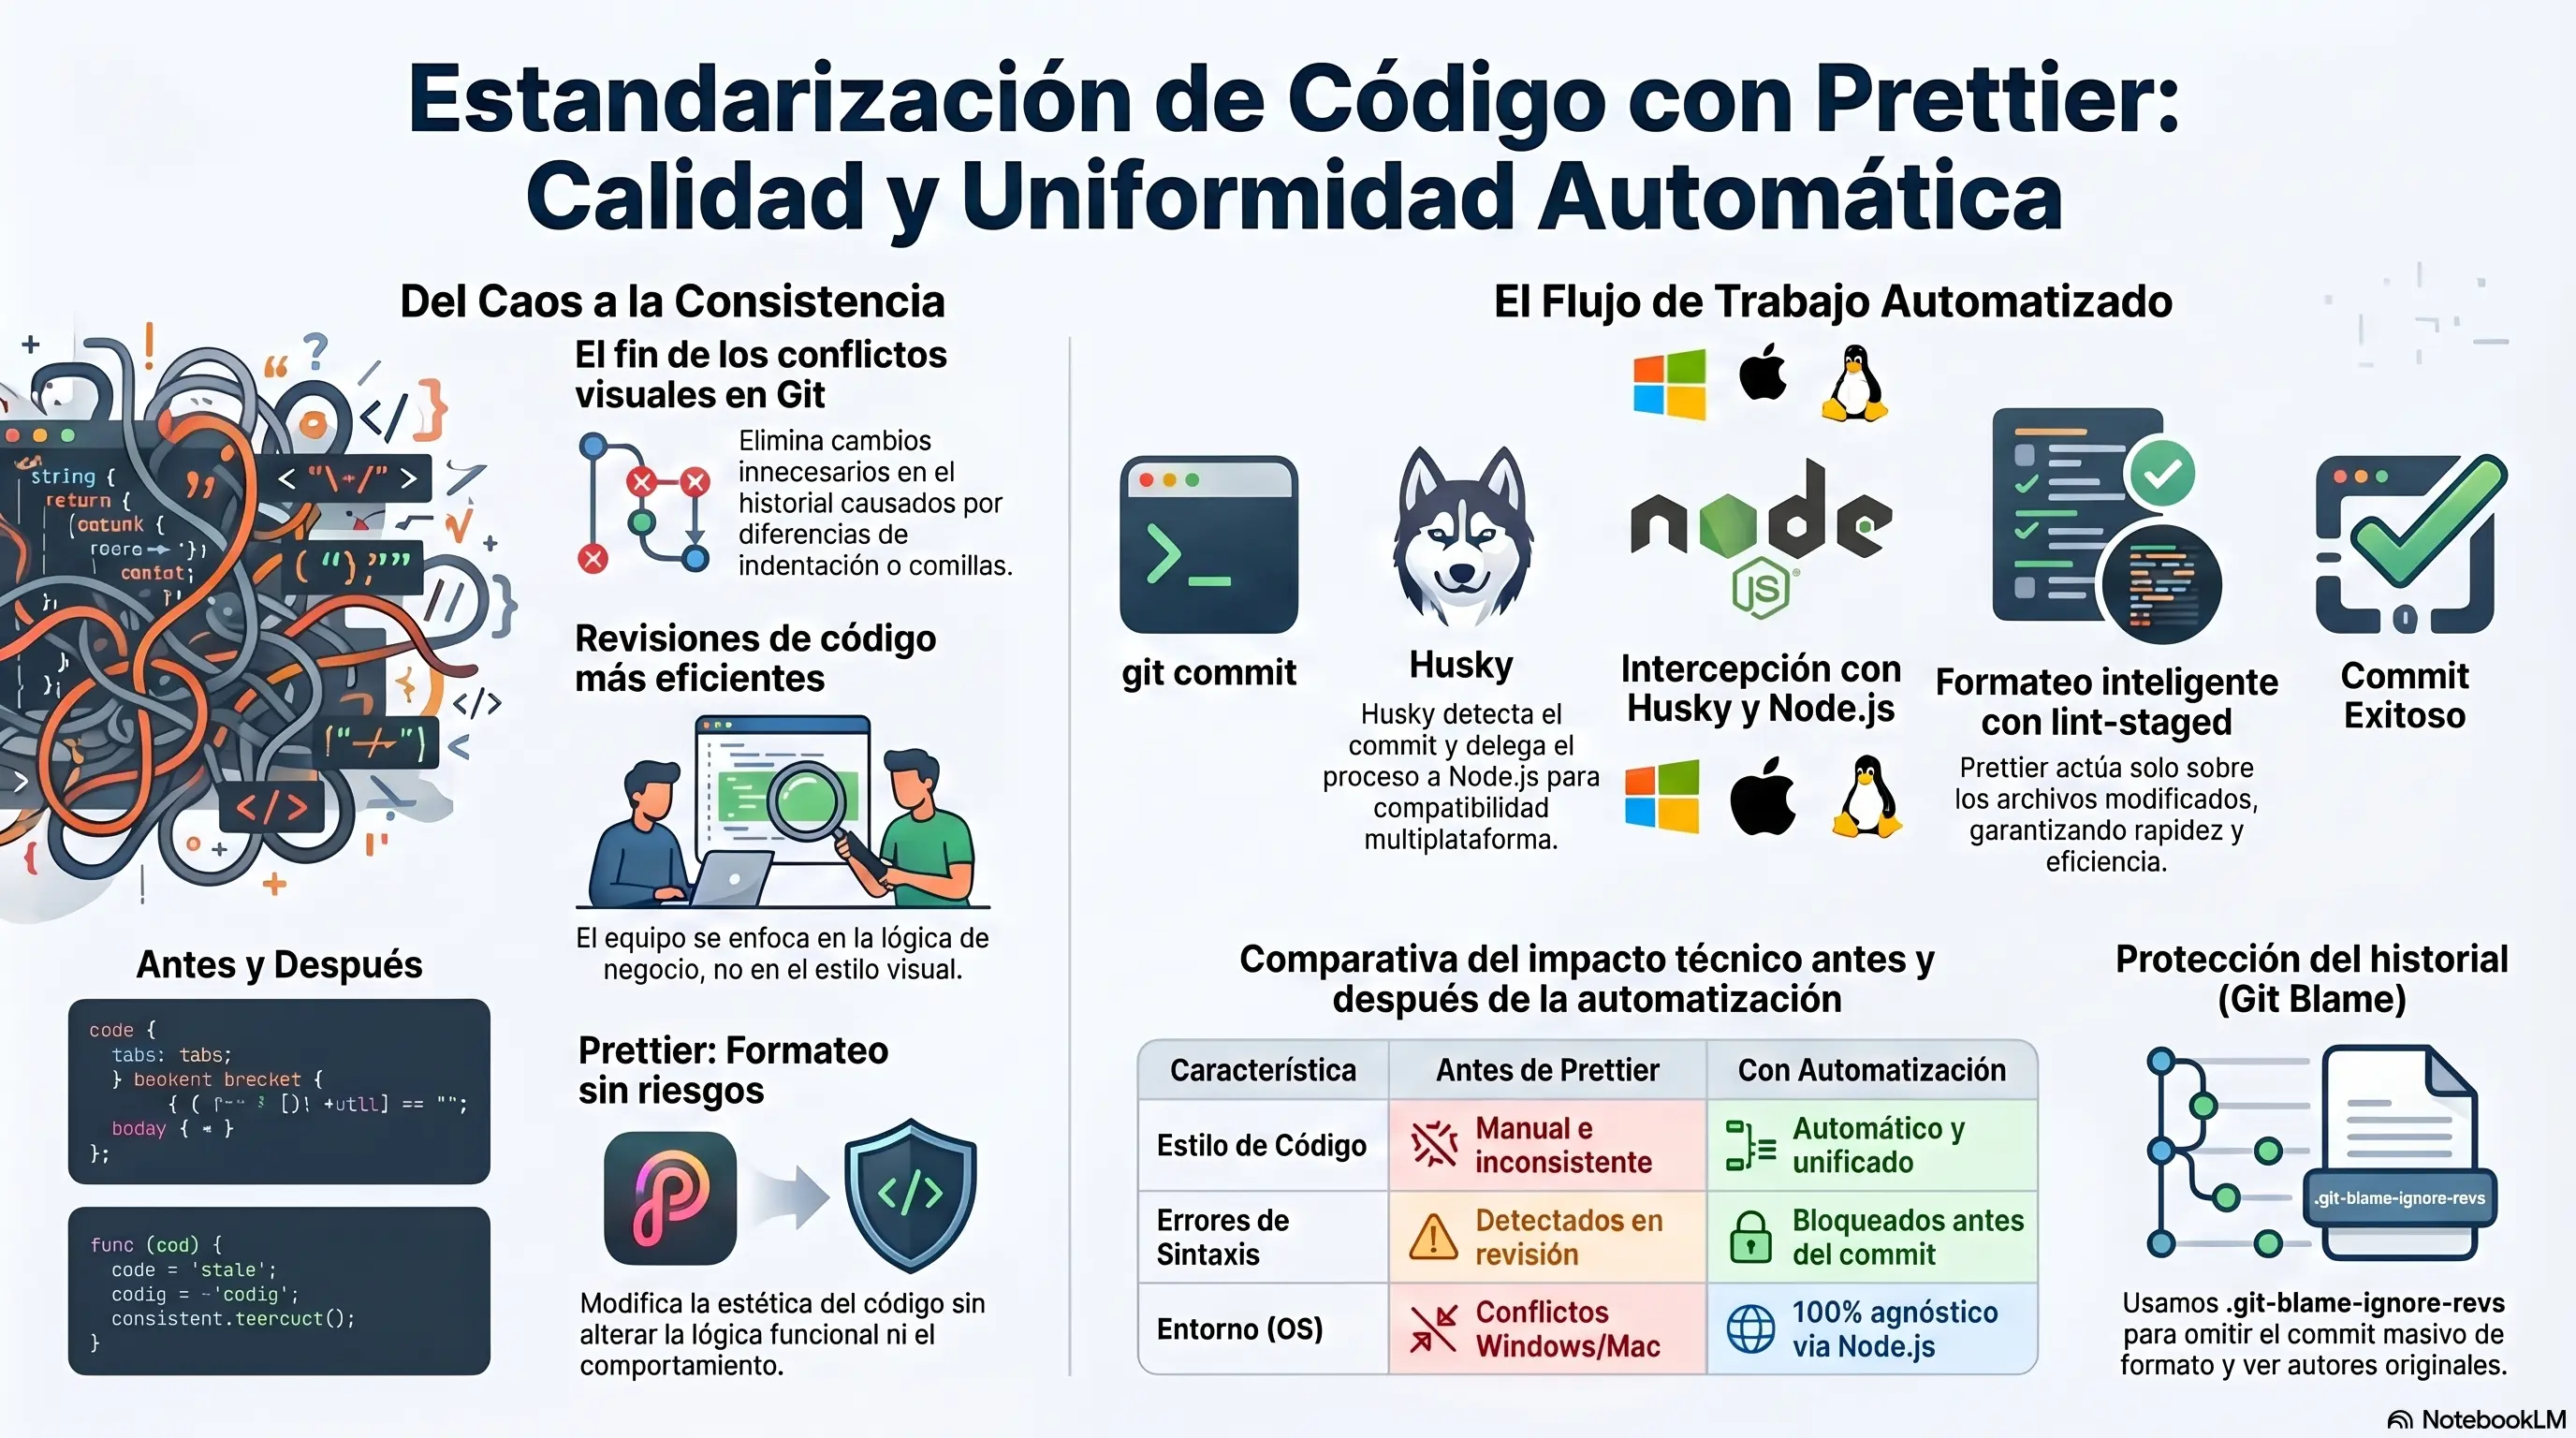
En proyectos de gran envergadura donde coexisten múltiples consultoras, la diversidad de criterios no es solo una riqueza cultural, sino también un riesgo técnico. Surge un problema tan silencioso como disruptivo: la inconsistencia visual. Cuando cada equipo aporta su propio ADN de desarrollo —unos prefieren tabulaciones, otros espacios; comillas simples frente a dobles— el repositorio deja de ser un activo cohesionado para convertirse en un campo de batalla de cambios irrelevantes.
Esta falta de unificación no es un simple detalle estético; es una fuente de fricción operativa y vendor finger-pointing —señalamiento entre proveedores— durante las revisiones de código. Las discusiones sobre la posición de una llave o la longitud de una línea roban minutos de oro que deberían invertirse en la arquitectura o la lógica de negocio.
💡 Para un líder técnico, estandarizar no es un capricho: es una estrategia para eliminar el ruido y garantizar que los Code Reviews se centren en lo que realmente aporta valor.
✨ El Fin de las Guerras de Estilo con Prettier
La solución para erradicar estas fricciones es delegar la responsabilidad en Prettier. Como formateador de código opinativo, Prettier elimina la subjetividad al parsear el código y reimprimirlo bajo reglas estrictas y predefinidas.
Lo que lo hace indispensable para un Arquitecto de Software es su seguridad: Prettier actúa sobre la capa de presentación sin alterar el Árbol de Sintaxis Abstracta (AST). Esto ofrece una garantía fundamental:
"El funcionamiento de la aplicación se mantiene exactamente igual"
Adoptar Prettier es, en esencia, un acto de liberación para el equipo. Al automatizar el estilo, el desarrollador se desprende de la carga cognitiva de "encajar" visualmente con el resto, permitiendo que la Developer Experience (DevEx) fluya hacia la resolución de problemas complejos.
⚙️ Configuración mínima en .prettierrc
{
"arrowParens": "always",
"bracketSameLine": false,
"printWidth": 100,
"semi": true,
"singleQuote": true,
"tabWidth": 2,
"trailingComma": "es5"
}
🕵️ El "Hack" de Git para Formatear sin Perder el Rastro
El mayor temor al implementar un estándar en un proyecto vivo es el commit masivo. Al formatear toda la base de código de una vez, corremos el riesgo de oscurecer la autoría original. Si un desarrollador usa git blame para entender por qué se tomó una decisión técnica hace dos años, se encontrará con que el autor es "el bot de formateo", perdiendo la trazabilidad histórica.
Para evolucionar la base de código sin sacrificar este rastro, utilizamos el archivo .git-blame-ignore-revs.
🔍 Cómo funciona
Formateáis el proyecto completo y hacéis commit.
Obtenéis el hash del commit de formateo.
Lo registráis en .git-blame-ignore-revs:
# Commit de formateo masivo con Prettier — 2024-10-15
a1b2c3d4e5f6a1b2c3d4e5f6a1b2c3d4e5f6a1b2
Configuráis Git para que lo use automáticamente:
git config blame.ignoreRevsFile .git-blame-ignore-revs
Esta funcionalidad permite:
👤 Preservar la autoría original: Git ignora ese commit en los rastreos.
🏛️ Integridad del historial: GitHub y GitLab respetan este archivo, mostrando al verdadero autor de la lógica.
🔇 Evolución sin ruido: Alcanzad la perfección visual sin "ensuciar" la responsabilidad histórica de cada línea.
🌐 Node.js como la "Fuente de la Verdad" Multiplataforma
En ecosistemas modernos, especialmente en proyectos basados en Angular, la independencia del sistema operativo es crítica. El error clásico de muchas automatizaciones es depender de scripts en Bash, que suelen fallar en entornos Windows o requieren configuraciones manuales tediosas.
Nuestra arquitectura propone un cambio de paradigma: tratar el repositorio como un entorno de aplicación en lugar de un entorno de sistema. Al centralizar todo en Node.js, garantizamos un comportamiento cross-platform real:
💻 Agnosticismo de hardware: El flujo funciona igual en una MacBook M3 que en una estación Windows 10.
🔒 Entorno controlado: Si el desarrollador tiene instalado Node.js (requisito para Angular), la automatización funcionará por defecto.
📦 Unificación de herramientas: El package.json se convierte en la única fuente de la verdad.
🐶 Husky y lint-staged: Los Guardianes Silenciosos del Repositorio
Para que la estandarización sea efectiva, debe ser invisible y obligatoria. Implementamos un flujo de cumplimiento forzado mediante Husky y lint-staged, actuando como un filtro de calidad antes de que el código llegue al servidor:
🚀 Activación: El desarrollador ejecuta git commit.
🪝 Intercepción: Husky captura el evento y delega la ejecución a Node.js.
🎯 Filtrado Inteligente: lint-staged identifica únicamente los archivos en el Staging Area. No perdemos tiempo procesando miles de archivos; solo lo que ha cambiado.
✅ Formateo y Validación: Prettier aplica el formato. Si el código tiene errores de sintaxis graves, el commit se aborta.
📦 Instalación
npm install --save-dev husky lint-staged
npx husky init
🔧 Configuración en package.json
{
"lint-staged": {
"*.{ts,html,scss,json,md}": ["prettier --write"]
}
}
Hook pre-commit (.husky/pre-commit)
node_modules/.bin/lint-staged
🛡️ Este proceso elimina el factor del olvido humano y garantiza que ningún código fuera de estándar entre jamás al repositorio, sin que el desarrollador tenga que ejecutar un solo comando adicional.
📋 Plan de Acción: Prueba de Concepto (POC)
Como Arquitectos, no implementamos cambios críticos a ciegas. El camino hacia la excelencia visual sigue una hoja de ruta técnica clara:
🌿 Aislamiento: Crear una rama feature/estandarizacion-prettier para no interrumpir el flujo actual.
⚙️ Configuración: Instalar el stack (Prettier, Husky, lint-staged) y definir las reglas en .prettierrc.
💥 Ejecución Masiva: Formatear el proyecto completo y generar el commit de referencia.
🛡️ Blindaje del Historial: Configurar el archivo .git-blame-ignore-revs con el hash obtenido.
🎬 Demo en Vivo: Mostrar al equipo y al cliente cómo un código mal indentado en Windows se corrige instantáneamente al hacer commit, manteniendo la autoría original en el historial.
🚀 Conclusión: Hacia una Cultura de Código Limpio
La adopción de este ecosistema no es solo una mejora técnica; es una declaración de principios sobre la calidad. Los beneficios son inmediatos: revisiones de código más ágiles, un historial de Git impecable y la eliminación total de la fricción estética entre consultoras.
La inversión para implementar esta arquitectura es mínima frente al ahorro de tiempo y frustración a largo plazo. Al final del día, la pregunta para cualquier líder tecnológico es simple:
¿Cuánto tiempo está perdiendo su equipo discutiendo sobre el formato de las comas, cuando podrían estar fortaleciendo la arquitectura de su sistema?
La automatización es el puente entre el caos visual y la excelencia técnica. ¡Y feliz 4 de Mayo, que la fuerza os acompañe en cada commit! 🌌⚔️
Francisco Javier Antúnez Durán6 months ago